blog
Una base de datos puede funcionar y estar mal diseñada
Qué cambia cuando dejamos de pensar en tablas y empezamos a modelar el dominio: una comparación antes/después sobre relaciones, redundancia, histórico, datos derivados y reglas de negocio.
Hace unos días volví a comprobar algo que en bases de datos resulta fácil olvidar: que un modelo funcione no significa que esté bien diseñado.
Una base de datos puede aceptar registros, devolver consultas y no mostrar ningún error evidente. Incluso sus tablas pueden tener claves primarias y claves foráneas perfectamente válidas. Y, sin embargo, representar mal el problema.
El cambio importante aparece cuando dejamos de preguntar:
«¿Qué columnas necesito guardar?»
y empezamos a preguntar:
«¿Qué significa realmente cada dato y qué regla del mundo real estoy intentando representar?»
Ese paso es el que separa, muchas veces, una estructura que simplemente almacena información de un modelo de datos que puede mantenerse, crecer y seguir siendo comprensible con el tiempo.
La diferencia no está solo en tener más o menos tablas: está en que cada entidad, relación y atributo tenga un significado claro.
El primer diseño no parecía estar mal
Imaginemos un sistema genérico que debe gestionar empresas, elementos asociados a ellas y ciertas obligaciones que deben realizarse periódicamente.
Un primer modelo podría contener tablas equivalentes a:
- empresa;
- elemento;
- obligación;
- realización.
Hasta aquí no hay nada especialmente extraño.
También podríamos encontrar identificadores, referencias entre tablas, fechas y campos destinados a saber quién es responsable de cada cosa.
Visto rápidamente, el diseño parece razonable.
El problema aparece cuando empezamos a hacer preguntas.
Si una obligación pertenece a un elemento y ese elemento ya pertenece a una empresa:
¿necesita también la obligación guardar otra vez empresa_id?
Si una realización pertenece a una obligación, y podemos llegar desde esa obligación hasta el elemento y desde el elemento hasta la empresa:
¿qué aporta volver a guardar empresa_id en la realización?
Y si encontramos un campo llamado:
responsable_id
¿significa la persona responsable de que algo se realice o la persona que efectivamente lo realizó?
Aquí comienza el verdadero diseño.
No estamos discutiendo nombres de columnas. Estamos intentando descubrir qué significa el dominio.
Antes y después: el modelo cambia cuando entendemos el problema
La siguiente imagen resume uno de los cambios fundamentales.
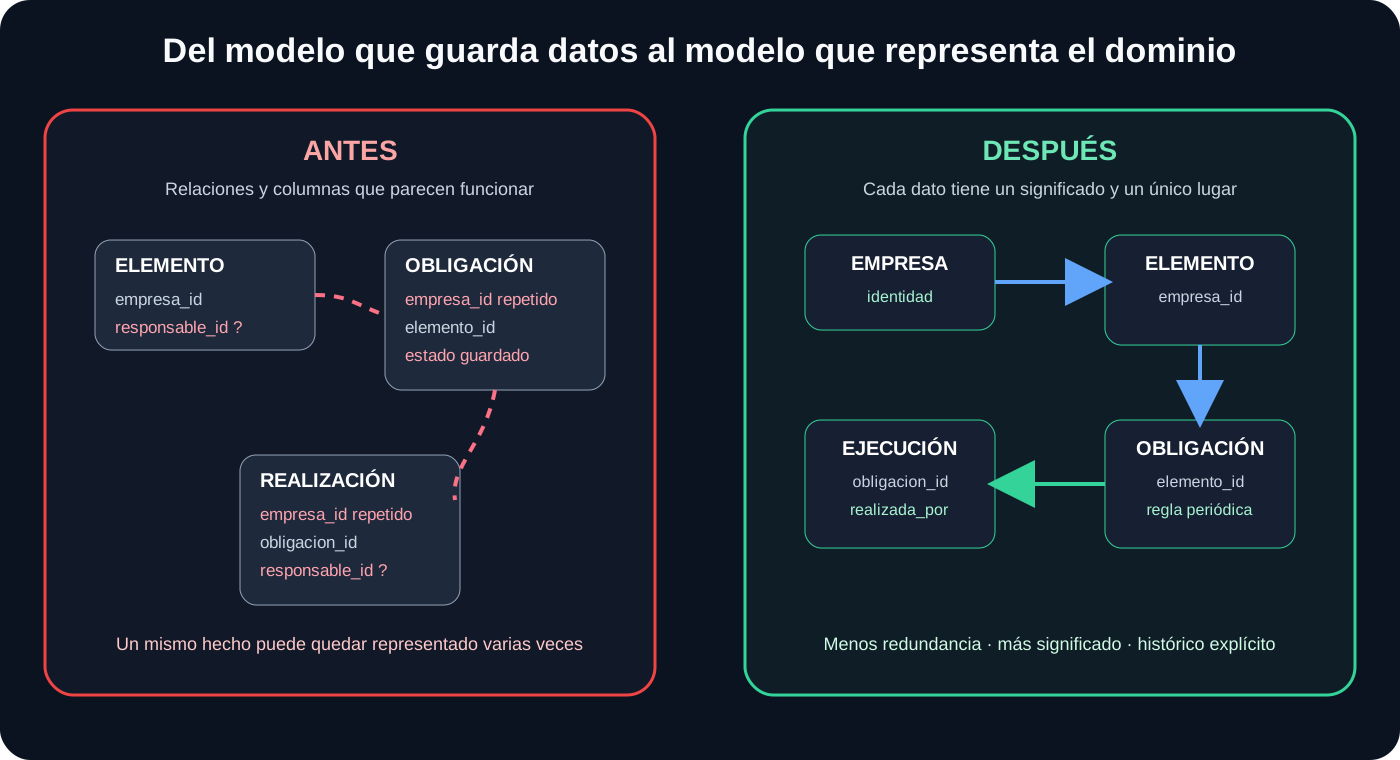
En el modelo inicial podían aparecer datos repetidos en varias tablas porque parecían útiles o cómodos.
En el modelo revisado intentamos que cada hecho tenga un único lugar natural.
Por ejemplo:
EMPRESA
   ↓
ELEMENTO
   ↓
OBLIGACIÓN
   ↓
EJECUCIÓN
La relación ya nos permite recorrer el modelo.
Si una obligación pertenece a un elemento y el elemento pertenece a una empresa, almacenar también la empresa en la obligación introduce una segunda forma de expresar el mismo hecho.
Y eso abre la puerta a algo peligroso:
elemento.empresa_id   = Empresa A
obligacion.empresa_id = Empresa B
La base de datos podría acabar diciendo dos cosas distintas sobre una misma relación.
La redundancia no es únicamente «gastar espacio».
Puede significar tener dos versiones de la verdad.
Una clave foránea no sirve solo para conectar tablas
Cuando empezamos a estudiar bases de datos es fácil aprender una definición parecida a esta:
Una clave foránea es un campo que referencia la clave primaria de otra tabla.
Es correcto.
Pero es una definición incompleta desde el punto de vista del diseño.
Una FK expresa una afirmación sobre el dominio.
Si tenemos:
elemento.empresa_id
realmente estamos diciendo:
«Este elemento pertenece a esta empresa».
Y si tenemos:
ejecucion.obligacion_id
estamos diciendo:
«Esta ejecución corresponde a esta obligación».
Por eso no basta con que el identificador tenga el formato correcto.
Una relación debe tener sentido semántico.
Podemos escribir un UUID sintácticamente perfecto y seguir representando una relación absurda.
El nombre de una columna también puede esconder un problema
Pensemos de nuevo en:
responsable_id
Parece bastante claro.
Hasta que preguntamos:
¿responsable de qué?
Puede significar:
- la persona encargada habitualmente de una obligación;
- la persona que ejecutó una actuación concreta.
No son la misma información.
El responsable pertenece a la regla organizativa.
La persona que realizó algo pertenece al hecho histórico.
Una columna llamada responsable_id en ambos lugares puede ocultar esa diferencia.
Un nombre más explícito, por ejemplo:
realizada_por
en el registro histórico deja mucho menos espacio para interpretaciones.
Una buena base de datos también se diseña eligiendo nombres que expliquen el modelo sin necesitar una conversación con quien lo creó.
Regla y hecho: obligación no es ejecución
Este fue otro cambio conceptual importante.
Una obligación puede expresar:
«Esto debe realizarse cada doce meses».
Una ejecución expresa:
«Esto se realizó el 18 de septiembre».
Son dos cosas diferentes.
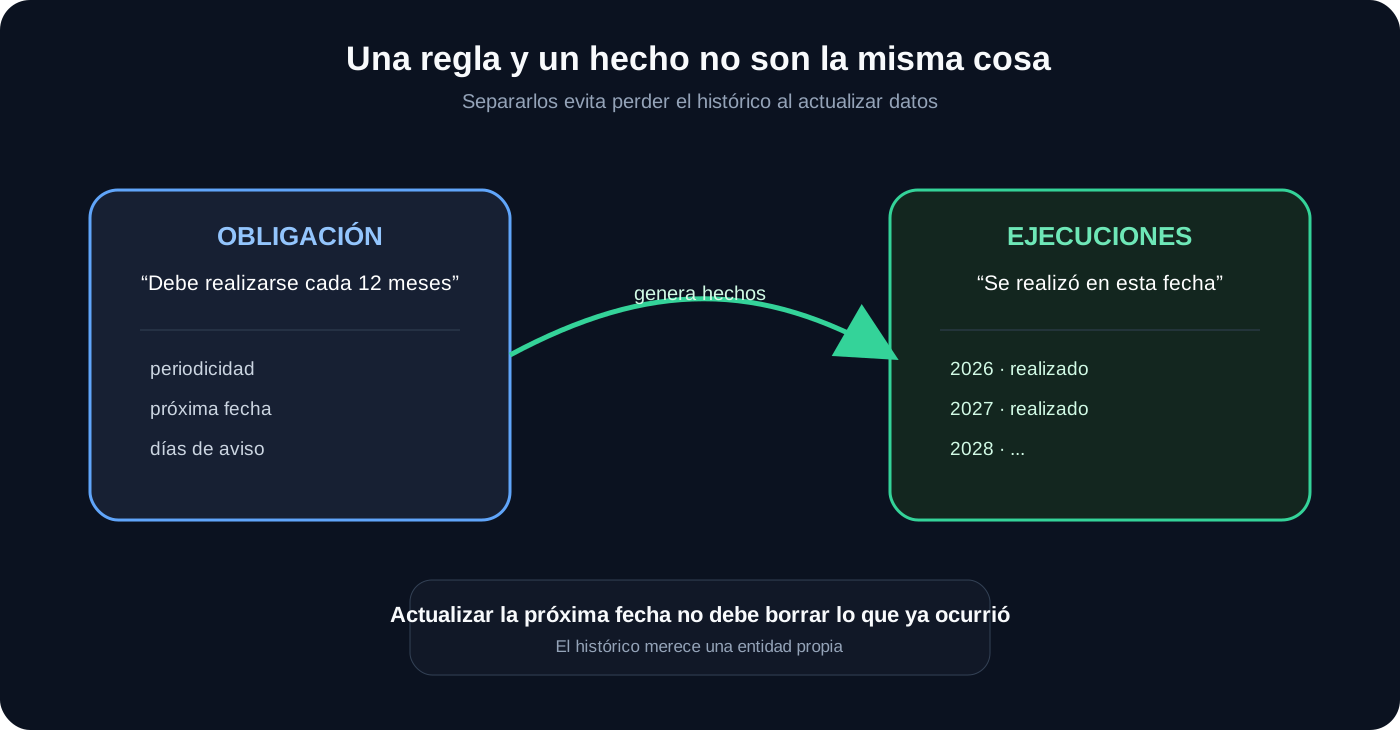
Si cada vez que algo se realiza simplemente sobrescribimos la próxima fecha, el sistema puede seguir funcionando.
Pero perdemos historia.
Después ya no podremos responder fácilmente:
- ¿cuándo se realizó anteriormente?;
- ¿cuántas veces se ha realizado?;
- ¿se hizo antes o después de la fecha prevista?;
- ¿quién lo hizo?;
- ¿qué observaciones se registraron?;
- ¿se está produciendo retraso de forma habitual?
Separar obligación y ejecución permite conservar ambas dimensiones:
la regla que sigue vigente y los hechos que ya ocurrieron.
Este patrón aparece en muchísimos dominios:
- una reserva y sus asistencias;
- una factura y sus pagos;
- un plan de mantenimiento y sus intervenciones;
- un curso y sus matrículas;
- una receta y sus dispensaciones.
Cuando algo puede suceder varias veces, conviene preguntarse si estamos ante una entidad propia y no ante una columna que iremos sobrescribiendo.
La periodicidad tampoco es solo texto
Otro detalle aparentemente pequeño es cómo representar una periodicidad.
Podríamos guardar:
anual
cada año
12 meses
1 año
365 días
Una persona puede interpretar varias de esas expresiones como equivalentes.
La base de datos no debería depender de esa interpretación.
Podemos estructurar el dato:
periodicidad_valor  = 1
periodicidad_unidad = año
o:
periodicidad_valor  = 6
periodicidad_unidad = mes
Pero incluso aquí aparece una regla importante:
valor = 6
unidad = NULL
no tiene sentido.
Tampoco:
valor = NULL
unidad = mes
Por eso un buen modelo no solo decide qué columnas existen. También establece qué combinaciones de valores son válidas.
Las restricciones forman parte del diseño.
No están ahí para molestar cuando insertamos datos.
Están ahí para impedir que almacenemos estados que el propio dominio considera imposibles.
Lo que vemos en pantalla no tiene por qué existir como columna
Esta idea suele costar al principio porque la interfaz nos condiciona mucho.
Si una aplicación muestra:
PENDIENTE
URGENTE
CORRECTO
es tentador crear una columna:
estado
Pero primero deberíamos preguntar:
¿El estado es un hecho independiente o se obtiene a partir de otros hechos?
El ejemplo clásico es la edad.
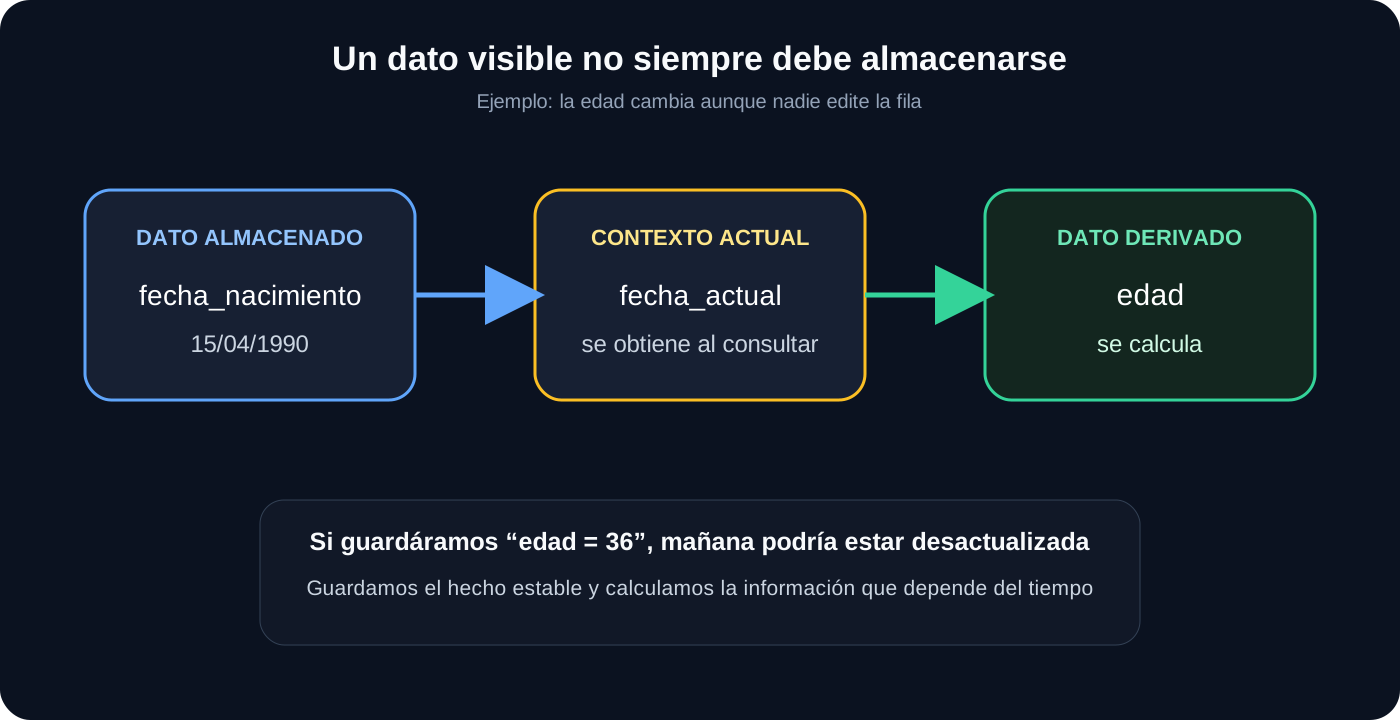
Podríamos guardar:
fecha_nacimiento = 15/04/1990
edad = 36
Pero la edad cambia con el tiempo aunque nadie modifique la fila.
Si almacenamos ambas cosas hemos creado dos datos que pueden contradecirse.
Es mucho más estable guardar:
fecha_nacimiento
y calcular la edad cuando sea necesaria.
Lo mismo sucede con muchos datos habituales:
importe_totalcuando puede calcularse a partir de líneas de detalle;dias_retrasocuando depende de la fecha límite y de la fecha actual;numero_pedidoscuando puede obtenerse contando registros relacionados;antiguedadcuando depende de una fecha de alta;- un nivel de alerta cuando se calcula con fechas y márgenes configurados.
Esto no significa que nunca debamos almacenar valores calculables. Hay casos de rendimiento, auditoría o necesidad histórica en los que puede ser razonable hacerlo.
La cuestión didáctica importante es otra:
No debemos guardar un dato solo porque aparezca en la interfaz.
Primero hay que preguntarse de dónde sale.
Entonces, ¿qué debe almacenarse?
Una forma útil de pensarlo es separar tres categorías.
1. Hechos que queremos conservar
Por ejemplo:
fecha_nacimiento
fecha_realizacion
precio_unitario
cantidad
2. Relaciones entre conceptos
Por ejemplo:
elemento → empresa
ejecución → obligación
3. Información que podemos obtener de lo anterior
Por ejemplo:
edad
número de ejecuciones
días de retraso
importe de una línea
No siempre la frontera es absoluta, pero hacerse esta pregunta mejora muchísimo un diseño.
Conocer el dominio cambia incluso las cardinalidades
Una de las preguntas más importantes de una relación es:
¿uno o muchos?
Imaginemos que una obligación tiene un responsable.
Podríamos crear:
obligacion.responsable_id
Eso modela perfectamente una situación en la que cada obligación tiene como máximo una persona responsable.
Pero ¿qué ocurre si el dominio dice:
Una obligación puede tener varios responsables y una persona puede responsabilizarse de varias obligaciones.
Ya no tenemos una relación 1:N sencilla.
Tenemos una relación N:M y necesitaremos representar esa relación explícitamente.
La base de datos no puede decidir esto por nosotros.
Necesitamos conocer cómo funciona la realidad que estamos modelando.
Ese es precisamente el tipo de decisión que una herramienta de IA tampoco puede resolver correctamente sin contexto.
Puede proponernos ambas alternativas.
Pero alguien debe saber cuál describe el problema real.
Una IA puede generar un SQL perfecto para el problema equivocado
Aquí aparece una paradoja interesante de las herramientas actuales.
Podemos explicar brevemente un sistema y obtener en segundos:
- tablas;
- claves primarias;
- claves foráneas;
- restricciones;
- consultas;
- índices;
- documentación.
El resultado puede parecer impecable.
Pero una IA no conoce automáticamente qué significa una palabra como:
elemento
responsable
ejecución
vencimiento
Conoce patrones de diseño de bases de datos.
No conoce nuestro dominio hasta que se lo explicamos.
Si la especificación es ambigua, tendrá que asumir.
Y una suposición incorrecta puede producir un modelo técnicamente elegante pero conceptualmente equivocado.
Por eso a veces es mejor no comenzar diciendo:
«Genera las tablas».
Puede ser mucho más útil empezar con:
«Hazme las preguntas que necesites antes de diseñar esta base de datos».
O:
«Indica qué supuestos estás haciendo».
O:
«Busca datos que estén representados más de una vez».
O:
«¿Qué información perderíamos al actualizar estos registros?».
Eso obliga a utilizar la IA como herramienta de análisis, no únicamente como generador de código.
Qué cambió realmente entre el modelo inicial y el revisado
Visto desde fuera, algunos cambios pueden parecer pequeños:
| Antes | Después | Qué hemos ganado |
|---|---|---|
| La empresa aparecía en varios niveles | Se obtiene recorriendo las relaciones | Evitamos representar dos veces el mismo hecho |
responsable_id tenía un significado ambiguo |
Diferenciamos responsabilidad y autoría de una ejecución | El modelo explica mejor el dominio |
| Una actuación podía quedar absorbida por la actualización de la obligación | Cada ejecución se registra por separado | Conservamos histórico |
| Algunos estados podían almacenarse directamente | Los estados temporales se calculan a partir de hechos | Evitamos información que envejece |
| La periodicidad podía considerarse simplemente un valor | Valor y unidad forman una regla coherente | Podemos validar combinaciones |
| Las tablas dictaban cómo entendíamos el problema | El dominio dicta qué tablas necesitamos | El modelo es consecuencia del análisis |
Esta última fila es, para mí, la más importante.
No se trata de conseguir un diseño «con más normalización» porque sí.
Se trata de que cada tabla tenga una razón de existir y cada relación pueda explicarse con una frase del mundo real.
Una pequeña prueba para saber si entendemos el modelo
Antes de escribir SQL, deberíamos poder explicar el diseño sin utilizar palabras de base de datos.
En lugar de:
«Esta tabla tiene una FK a esta otra».
deberíamos ser capaces de decir:
«Cada elemento pertenece a una empresa».
En lugar de:
«Tenemos una relación 1:N».
deberíamos decir:
«Una obligación puede generar muchas ejecuciones, pero cada ejecución corresponde a una única obligación».
En lugar de:
«Este campo está normalizado».
deberíamos decir:
«No necesitamos guardar aquí la empresa porque ya sabemos a qué empresa pertenece a través del elemento».
Cuando podemos describirlo así, normalmente hemos entendido bastante mejor el dominio.
Después ya podemos traducirlo a PK, FK, UNIQUE, CHECK, NOT NULL y demás herramientas del modelo relacional.
Para trabajar este concepto en clase
Una actividad sencilla consiste en dar únicamente los requisitos, sin mostrar las tablas.
Por ejemplo:
Una organización gestiona distintos elementos. Algunos elementos tienen obligaciones periódicas. Cada vez que una obligación se realiza debe quedar constancia de cuándo ocurrió. La aplicación debe mostrar qué obligaciones necesitan atención.
Y pedir al alumnado:
- identificar entidades;
- proponer relaciones;
- indicar sus cardinalidades;
- decidir qué datos almacenaría;
- señalar qué datos calcularía;
- explicar qué información histórica necesita conservar;
- proponer estados que nunca deberían poder almacenarse;
- escribir las preguntas que todavía necesitaría hacer al usuario.
Solo después se comparan las propuestas.
Normalmente aparecen varias soluciones aparentemente razonables.
Y ese es precisamente el punto interesante: diseñar no consiste en adivinar las tablas que tenía en mente el profesor.
Consiste en justificar qué realidad puede representar nuestro modelo y qué realidad no puede representar.
Checklist antes de crear una tabla
Antes de dar por bueno un modelo merece la pena revisar:
- ¿Qué concepto real representa cada tabla?
- ¿Cuál es su identidad?
- ¿Qué significa cada relación?
- ¿Las cardinalidades están claras?
- ¿Estoy guardando el mismo hecho en dos lugares?
- ¿Hay columnas con nombres ambiguos?
- ¿Estoy almacenando datos que dependen del tiempo y podrían calcularse?
- ¿Estoy sobrescribiendo información que debería formar parte del histórico?
- ¿Qué combinaciones de valores deberían ser imposibles?
- ¿Qué debería ocurrir al borrar una entidad relacionada?
- ¿El modelo podría explicarse sin hablar de SQL?
- ¿Qué suposiciones estoy haciendo porque todavía no conozco bien el dominio?
Si varias respuestas son «no lo sé», probablemente todavía no necesitemos crear más tablas.
Necesitamos hacer más preguntas.
Conclusión
El diseño de una base de datos no empieza con CREATE TABLE.
Empieza cuando intentamos comprender el significado de palabras aparentemente sencillas como «responsable», «estado», «realización» o «periodicidad».
Un primer modelo puede funcionar y, sin embargo, contener redundancias, ambigüedades o pérdidas de información que solo aparecen cuando empezamos a pensar en casos reales.
La mejora más importante no consiste necesariamente en añadir tablas.
Consiste en pasar de:
“¿Dónde guardo este dato?”
a:
“¿Qué significa este dato dentro del problema?”
Las herramientas de inteligencia artificial pueden acelerar muchísimo la parte técnica. Pueden proponer modelos, generar SQL, revisar restricciones y encontrar casos límite.
Pero no pueden conocer un dominio que todavía no hemos explicado.
Por eso conocer los fundamentos de bases de datos sigue siendo importante.
No para competir con una herramienta que escribe código más rápido.
Sino para poder decidir si el código que ha escrito representa realmente el problema que queríamos resolver.